Predecir antes de saber. Aprender después.
Quise llevar mi interés por la Fórmula 1 más allá de mirar carreras y convertirlo en una pregunta de datos: ¿cuánto se puede anticipar con lo que realmente se sabía antes de cada fin de semana? F1Predictor estima el orden de llegada, aprende después del resultado y repite esa secuencia desde 1951 hasta 2026.
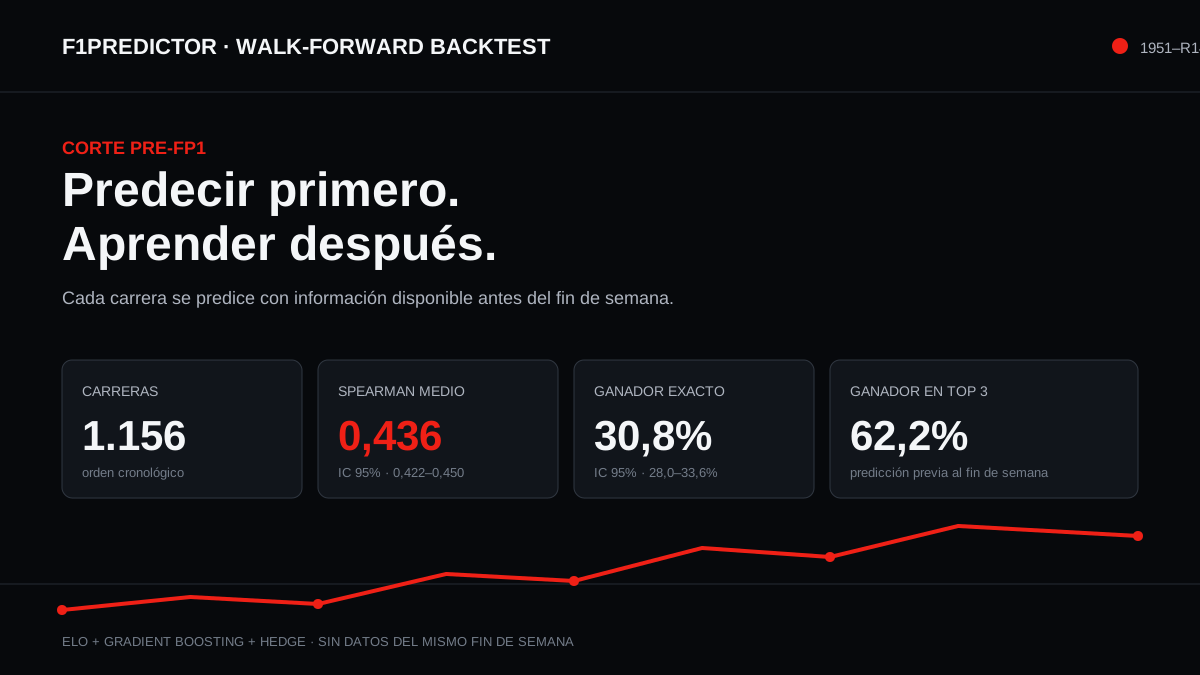
La frontera más importante es temporal.
Para reconstruir cada predicción, el modelo trabaja con la información disponible antes de la primera práctica: ratings acumulados, forma previa, circuito, pronóstico y confiabilidad histórica. Después del Gran Premio incorpora el resultado y avanza.
Se construye la predicción
Entran ratings acumulados, forma previa, circuito, pronóstico meteorológico, confiabilidad histórica y señales disponibles según la época.
Se revela el resultado
Se calculan los errores, se actualizan Elo y modelos, y recién entonces esa carrera puede informar la siguiente.
El código preserva la secuencia
Los tests verifican que cada ronda se prediga con el mismo límite temporal y convierten el método en una regla reproducible.
Una combinación que puede corregir su propia confianza.
Elo multicompetidor
Ratings globales, duelos contra el compañero y ritmo del constructor se actualizan mediante sorpresa: resultado observado menos resultado esperado.
Gradient boosting
Antes de cada carrera, un modelo de ventana expansiva se ajusta con todas las pruebas anteriores y aprende interacciones no lineales.
Mezcla Hedge
Después de cada ronda, multiplicative weights desplaza confianza hacia la capa que ordenó mejor ese pelotón.
Riesgos separados
Clasificadores adicionales estiman abandono por accidente y por falla mecánica, y se evalúan por calibración.
Cada época aporta una combinación distinta de información.
Forma y similitud
Un fingerprint numérico describe longitud, curvas, carga, adelantamiento, elevación, altitud y velocidad para transferir experiencia entre trazados similares.
Capacidades separadas
El Elo del piloto se combina con el duelo interno contra su compañero y con un rating de ritmo del constructor.
Ventanas móviles
Posición, puntos, grilla, abandonos y tendencia usan únicamente las carreras ya disputadas.
Contexto previo a la carrera
Desde 2022 se incorpora el archivo de pronósticos; para temporadas anteriores, la climatología histórica completa el contexto disponible.
Una lectura que gana detalle
Los pit stops se incorporan desde 2011 y las señales de estrategia e incidentes de OpenF1 desde 2023.
Accidente versus mecánica
Separar ambos tipos de abandono permite modelar mejor cuánto corresponde al piloto y cuánto al auto.
Superar una referencia competitiva.
La comparación usa una línea base que ordena a los pilotos por su promedio móvil de posición final: una heurística simple, sólida y disponible bajo las mismas condiciones.
| Métrica | F1Predictor | Línea base | Lectura |
|---|---|---|---|
| Spearman medio | 0,436 | 0,384 | Mejora pareada de +0,051 |
| Ganador exacto | 30,8% | 26,8% | +4 puntos porcentuales |
| Significancia | p = 6,8 × 10⁻³⁸ | Wilcoxon sobre diferencias por carrera | |
| Podio compartido | 47,8% | — | IC 95%: 46,2–49,3% |
Reconstruir 75 años sin dejar que el futuro se filtre hacia atrás.
El proceso ordena cada Gran Premio por fecha y reproduce una secuencia fija: construir variables, entrenar con el pasado disponible, predecir, guardar la predicción, revelar el resultado y actualizar el estado. Esa disciplina evita que una victoria, una mejora técnica o un abandono influya en la estimación que supuestamente se hizo antes de que ocurriera.
Las variables no se tratan como una fotografía única. El rendimiento del piloto cambia carrera a carrera; el duelo con el compañero separa parte del efecto del auto; el constructor acumula su propio ritmo; la forma usa ventanas móviles; y el fingerprint del circuito permite transferir experiencia entre trazados parecidos. Cuando una señal todavía no existía históricamente, el pipeline utiliza solo el sustituto disponible para esa época.
Antes de cada ronda, el gradient boosting se vuelve a ajustar con una ventana expansiva. En paralelo, los ratings Elo producen una lectura más interpretable de capacidad relativa. La mezcla Hedge observa cuál de las capas ordenó mejor el último pelotón y modifica su peso para la siguiente carrera. El sistema no elige un ganador fijo entre modelos: aprende cuánto confiar en cada uno a medida que avanza la historia.
Congelar el corte
Definir el instante previo al fin de semana y construir todas las variables con información anterior.
Ordenar la grilla
Combinar ratings, forma, circuito, clima y confiabilidad en una predicción completa del pelotón.
Medir el error
Comparar el orden previsto con el resultado real mediante métricas de ranking, ganador, podio y calibración.
Actualizar el estado
Incorporar la carrera recién terminada y repetir exactamente el mismo contrato en la ronda siguiente.
La predicción también sirve para entender por qué una carrera es difícil de anticipar.
Guardar cada pronóstico antes del resultado permite mirar mucho más que el promedio final. Se pueden localizar épocas donde el auto domina la señal, circuitos donde la similitud ayuda, temporadas con mayor incertidumbre y fines de semana donde accidente y confiabilidad alteran el orden competitivo. El error deja de ser un único número y se convierte en material para investigar.
Datos que cambian con la historia
La cobertura progresiva muestra cuánto aporta cada fuente moderna sin fingir que estuvo disponible en 1951.
Capacidad versus contexto
Elo general, duelo interno y ritmo del constructor permiten observar trayectorias desde ángulos complementarios.
Transferencia entre trazados
El fingerprint convierte longitud, curvas, altitud, carga y adelantamiento en una estructura comparable.
Dos riesgos distintos
Separar accidente y falla mecánica ayuda a estudiar la probabilidad de terminar antes de ordenar posiciones.
Confianza que se puede medir
Las probabilidades se contrastan con frecuencia real para revisar si el modelo es seguro, tímido o excesivamente confiado.
Resultados explorables
Las series se integran con Telemetry One para comparar pilotos, autos y carreras sin perder la versión del modelo.
Un laboratorio personal de análisis deportivo.
- Modelado temporal: construí un flujo que aprende en orden cronológico y reproduce las condiciones de información de cada Gran Premio.
- Ingeniería de variables: combiné piloto, constructor, circuito, clima, forma y confiabilidad en señales comparables a través de 75 años.
- Evaluación rigurosa: contrasté el sistema con una línea base competitiva y medí ranking, ganador, podio, calibración e incertidumbre.
- Análisis exploratorio: el modelo permite comparar eras, descubrir patrones y formular preguntas nuevas sobre rendimiento y contexto.
- Construcción reproducible: código, tests y resultados forman una base que se puede inspeccionar, extender y conectar con Telemetry One.
Construido con Python y verificado con tests.
El pipeline está escrito en Python con pandas, NumPy, scikit-learn y SciPy, y toma datos de Jolpica, OpenF1 y archivos meteorológicos. Lo desarrollé en sesiones con Claude Code: los tres commits del repositorio llevan esa coautoría. La regla temporal no depende de la confianza en el código: un test específico verifica que ninguna predicción use información posterior a su fecha de corte.